Wyobraź sobie, że za każdym razem, gdy odwiedzasz stronę internetową, musi ona od nowa przetwarzać wszystkie dane, aby wczytać obrazy, wyświetlić podstrony lub pobrać informacje. Nie tylko wydłuża to czas odpowiedzi, ale też dodatkowo obciąża serwer i zasoby systemowe. Właśnie tutaj z pomocą przychodzi cache, czyli buforowanie danych. Przechowując często używane dane w szybszej pamięci, cache może skrócić czas dostępu do danych i poprawić wydajność systemu. Jak jednak działa cache, jakie są jego rodzaje i jakie wyzwania mogą pojawić się podczas jego stosowania?
Czym jest cache?
Cache (buforowanie) to proces przechowywania często używanych danych w określonej pamięci. Załóżmy, że co kilka minut potrzebujesz dostępu do konkretnej aplikacji lub określonych danych. Ponieważ dane te są często wykorzystywane, przechowuje się je w miejscu zwanym pamięcią podręczną (cache), dzięki czemu nie trzeba ich pobierać za każdym razem, gdy z nich korzystasz. Powodów stosowania cache jest wiele, ale jednym z najważniejszych jest skrócenie czasu dostępu do danych.
Dyski twarde działają wolno i nawet najszybsze z nich nie dorównują szybkości pamięci RAM i procesora. Z tego powodu pobieranie z nich danych zajmuje czas. Pamięć podręczna jest jednak inna, ponieważ to rodzaj pamięci o dużej szybkości. Ma ona ograniczoną pojemność i może przechowywać tylko często używane dane.
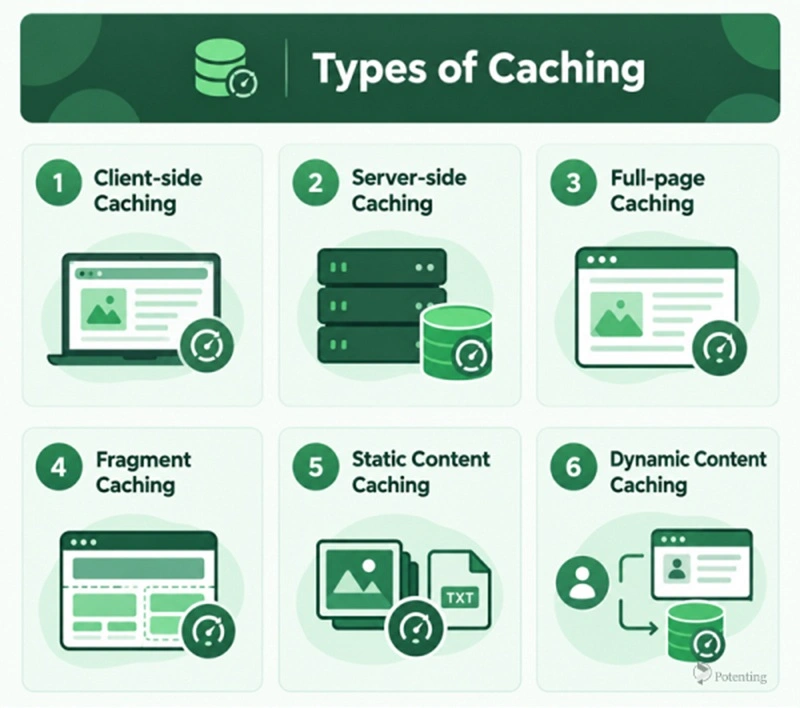
Rodzaje cache
W tej części omówimy różne rodzaje cache i ich zastosowania.
Cache po stronie klienta
W tej metodzie dane są przechowywane po stronie klienta, zwykle w przeglądarce internetowej. Przeglądarka może zapisywać w swojej pamięci podręcznej kopie stron internetowych i zasobów, takich jak obrazy, aby przy kolejnych wizytach wyświetlać je bez ponownego pobierania z serwera. Na przykład, sprawdzając, kiedy strona została ostatnio zmodyfikowana, przeglądarka może ustalić, czy wersja zapisana w cache jest nadal aktualna.Cache po stronie serwera
W tej metodzie dane są przechowywane po stronie serwera, aby szybciej odpowiadać na żądania i zmniejszać obciążenie serwera oraz sieci. Przykładem jest użycie buforującego serwera proxy, który może przechowywać żądane treści i w razie potrzeby udostępniać je innym użytkownikom. DynaCache w IBM WebSphere Application Server to kolejny przykład mechanizmu cache po stronie serwera.Cache całych stron
W tej metodzie przechowywana jest kopia całej wyrenderowanej strony internetowej, dzięki czemu przy kolejnych żądaniach można ją dostarczyć bez ponownego wykonywania wszystkich procesów generowania treści. Metoda ta sprawdza się jednak tylko wtedy, gdy treść strony może być buforowana, a jej zmiany są odpowiednio zarządzane.Cache fragmentów
W tej metodzie zamiast całej strony buforowane są niezależnie jej wybrane sekcje. Takie podejście jest przydatne, gdy strona zawiera zarówno treści statyczne, jak i dynamiczne. Buforując sekcje, które można przechowywać, można poprawić wydajność strony bez konieczności zapisywania jej w cache jako jednej całości.Cache treści statycznych
Ta metoda służy do przechowywania treści, które zmieniają się rzadko, takich jak obrazy graficzne i pliki tekstowe. Ponieważ treści te zazwyczaj nie wymagają częstych aktualizacji, przechowywanie ich kopii w cache może zmniejszyć liczbę żądań do serwera źródłowego i skrócić czas wczytywania stron.Cache treści dynamicznych
W tej metodzie buforowane są treści, które mogą często się zmieniać lub są generowane na podstawie informacji o użytkowniku i określonych warunków. Ponieważ treści dynamiczne mogą być spersonalizowane, szczególnie ważne jest zarządzanie aktualnością cache i określanie, kiedy należy go odświeżyć. DynaCache w IBM WebSphere Application Server to przykład rozwiązania do buforowania treści dynamicznych.
Dlaczego warto korzystać z cache?
Jak wspomniano wyżej, jednym z powodów stosowania cache jest przyspieszenie dostępu do często używanych danych. Ponadto cache zmniejsza obciążenie obliczeniowe serwera. Ale dlaczego?
Gdy system często potrzebuje określonych danych i musi pobierać je z pamięci masowej, zajmuje to nie tylko więcej czasu, ale wymaga też dodatkowej pracy procesora (CPU) i innych zasobów systemowych. Jeśli jednak dane te są dostępne w cache, system może sięgnąć do pamięci podręcznej i pobrać je bez ponownego odwoływania się do pamięci masowej.
Cache ma też inne zalety, które łatwiej zrozumieć na przykładzie. Załóżmy, że masz 10 GB danych do zapisania. Ponieważ procesor jest znacznie szybszy niż system pamięci masowej, ten ostatni może nie być w stanie zapisywać danych w tym samym tempie. Tu właśnie przydaje się cache. Procesor wysyła dane do pamięci podręcznej, a ta przekazuje je do systemu pamięci masowej w odpowiednim tempie. Dzięki temu procesor może kontynuować pracę bez zbędnych opóźnień, a dane zostają poprawnie zapisane.
Jak hosting wpływa na wydajność strony internetowej?
Cache może znacząco poprawić wydajność strony internetowej, ale nie jest jedynym czynnikiem decydującym o tym, jak szybko się ona wczytuje. Ważną rolę odgrywa również infrastruktura hostingowa. Zasoby serwera, takie jak CPU, RAM, szybkość pamięci masowej i wydajność sieci, mogą wpływać na tempo przetwarzania żądań, zwłaszcza gdy strona ma duży ruch.
Nawet przy skutecznej strategii cache wydajność strony może pozostać niska, jeśli środowisko hostingowe nie radzi sobie sprawnie z jej obciążeniem. Wybór usługi hostingowej z wystarczającymi zasobami i niezawodną wydajnością może pomóc skrócić czas odpowiedzi serwera i poprawić doświadczenia użytkowników. Dlatego jeśli chcesz zwiększyć szybkość i wydajność swojej strony, oprócz wdrażania technik optymalizacji warto zapoznać się z planami hostingu dopasowanymi do potrzeb Twojej witryny.
Jak działa cache?
Cache występuje w różnych odmianach i jest formą przechowywania danych. Gdy pojawia się żądanie danych, najpierw sprawdzana jest pamięć podręczna, a dopiero potem dane są pobierane z dysku twardego. Ponieważ jednak pamięć podręczna ma ograniczoną pojemność, nie da się w niej przechowywać wszystkich danych systemu. Dlatego system musi określić, które dane powinny trafić do cache.
Z kolei gdy pamięć podręczna jest pełna, a trzeba dodać nowe, często używane dane, system musi zdecydować, które z istniejących danych usunąć. Służą do tego różne algorytmy, które oceniają, które dane mają najmniejsze szanse na ponowne użycie.
Czym jest cache miss?
Gdy aplikacja żąda różnych rodzajów danych, żądania te trafiają do pamięci podręcznej. Jeśli żądanych danych nie ma w cache, rośnie liczba chybień (cache miss). Oznacza to, że system wielokrotnie odwoływał się do pamięci podręcznej, ale ponieważ potrzebnych danych w niej nie było, musiał pobrać je z pamięci masowej.
Obniża to wydajność systemu. Aby rozwiązać ten problem, można zwiększyć pojemność pamięci podręcznej.
Czym jest kontroler RAID?
Kontroler RAID to sprzętowy komponent serwerów zaprojektowany specjalnie w celu poprawy wydajności buforowania i przechowywania danych. Dzięki pamięci flash jego cache zapewnia dodatkową przestrzeń i znacząco zwiększa wydajność serwera.
Wyzwania związane z cache
- Lokalny cache: przechowywanie różnych wersji tych samych danych w wielu systemach może prowadzić do niespójności danych i obniżać skuteczność buforowania.
- Problem spójności cache: gdy dane zmieniają się w jednej pamięci podręcznej, wyzwaniem staje się synchronizacja odpowiadających im kopii w pozostałych pamięciach podręcznych.
- Penetracja cache (cache penetration): występuje, gdy żądanych danych nie ma ani w cache, ani w źródłowej bazie danych. Ograniczyć ten problem może zastosowanie filtra Blooma.
- Lawina cache (cache avalanche): awaria pamięci podręcznej lub jednoczesne wygaśnięcie dużej liczby buforowanych elementów może skierować do bazy danych ogromną liczbę żądań i potencjalnie spowodować zakłócenia. Złagodzić ten problem może użycie klastra cache oraz narzędzi takich jak Hystrix.
Podsumowanie
Cache to skuteczny sposób na poprawę wydajności systemu, skrócenie czasu dostępu do danych i zmniejszenie obciążenia obliczeniowego serwerów. W zależności od wymagań systemu można stosować różne metody buforowania, aby przechowywać często używane dane i szybciej je dostarczać. Kluczowe są jednak wybór właściwej strategii cache i prawidłowe zarządzanie buforowanymi danymi, aby utrzymać wydajność i zapobiegać problemom, takim jak cache miss, brak spójności cache czy lawina cache. Zrozumienie, jak działa cache, jakie są jego rodzaje i potencjalne wyzwania, pomaga podejmować lepsze decyzje przy projektowaniu i optymalizacji systemów.
FAQ
1. Jak działają algorytmy usuwania danych z cache?
Algorytmy usuwania danych z cache (cache eviction) określają, które dane należy usunąć, gdy pamięć podręczna osiągnie swoją pojemność. Algorytmy takie jak LRU (Least Recently Used) i LFU (Least Frequently Used) wybierają dane na podstawie tego, jak dawno lub jak często były używane.
Stosowanie obu metod zwiększa bezpieczeństwo serwera dedykowanego i dostępność usług.
2. Czym jest spójność cache i dlaczego jest ważna?
Spójność cache (cache coherence) zapewnia, że wiele buforowanych kopii tych samych danych pozostaje zgodnych po wprowadzeniu zmian. Jest to szczególnie ważne w systemach rozproszonych i środowiskach wieloprocesorowych, w których wiele pamięci podręcznych może przechowywać kopie tych samych danych.



